当我们在抱怨AI不讲人话时,我们在抱怨什么?
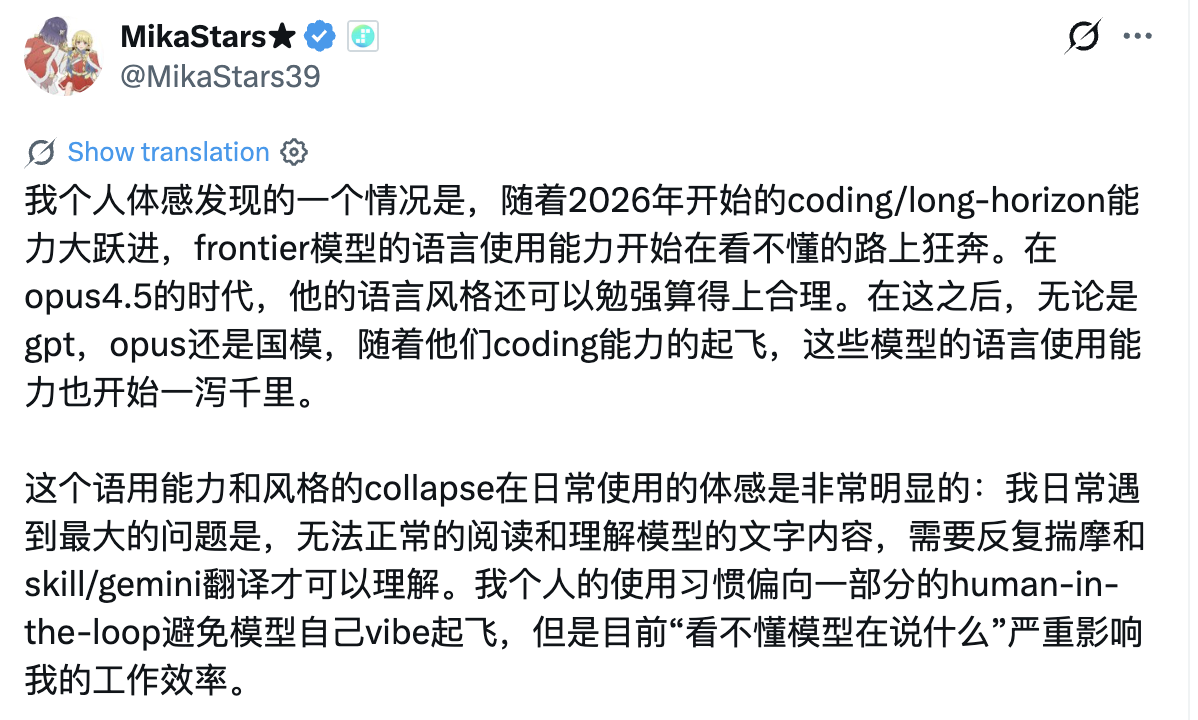
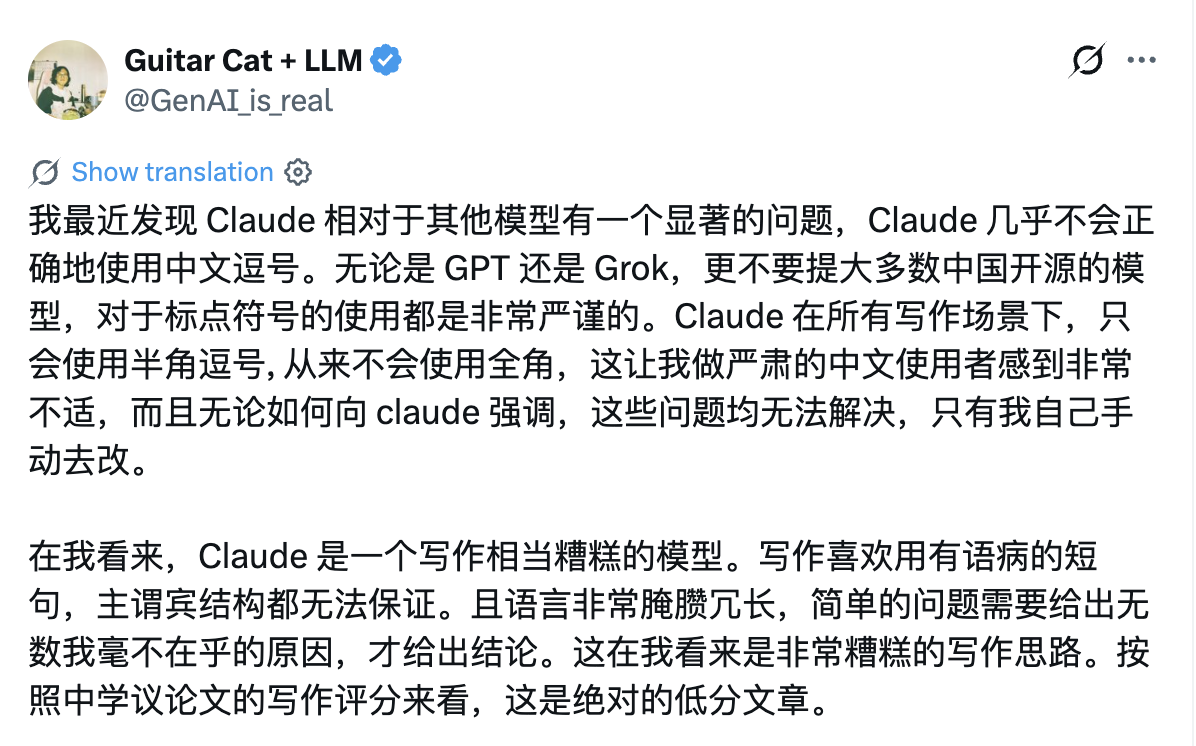
这段时间可以看到社区有许多讨论AI“不说人话”现象的帖子,并且,AI”不说人话“也某种程度成为了一个出圈的梗(许多AI短剧中的“怕,但账要算清”“吃了不烧心”句式实际也是出自“不说人话”的AI)。对于这些现象,大家普遍认为AI输出的内容: (i) 存在许多固定的AI slop,例如破折号,”Prism“,”不是而是“等句式词语模板;(ii) 会过度压缩,自创许多”黑话“和防御性写作,导致读者读起来很难懂,信息量很低; (iii) 输出内容缺乏多样性,最后导致社区内容同质化。许多博主也贴出了防止AI”不说人话“的prompt或者skills,一些最近的papers也对这类不说人话进行了探索,但整体感觉都比较分散,这里希望结合最近的一些工作,聚焦讨论一下模型”不说人话“的具体表现,以及个人认为可以探索的方向和对这个方向的思考。总结起来,目前社区和学界主要认为AI输出的文字存在这三个问题:
- AI的语言存在与人类不同的用词,造句偏好;
- 相较于人类,AI输出语言的信息密度更高
- 在和人类交互的过程中,AI和人类并没有形成好的common ground。
用词,句式偏好差异
在2026年伊始,牛津词典就将ai slop视作2025年的年度词汇。早在2025年9月,就有研究者尝试测量模型中的ai slop含量 [1],在这篇文章的定义中,“Slop”指的是信息空洞或跑题、事实不可靠、风格冗长重复,从而让人觉得低质、多余的文本。作者通过人类专家和编辑建立slop的类别与标注片段,并测试各个方法检测的效果。结果显示,人类对于slop的片段有比较统一的感知,这种分类体系也是有效的。然而,AI slop的自动检测很难做,基于当时LLM的方法,与人类的一致性也近乎为0。基于句法特征的方法表现最好,但判断的准确率也仅有0.64–0.68。而ICLR 2026的antislop [2] 则循环统计模型输出与英语词频库wordfreq的比值,来说明某个词被AI滥用的程度。例如,模型第一轮写作了2000篇小说,检测到”Elara“这个词滥用最为严重,就将其视作slop禁止生成,然后迭代再生成,观察下一轮哪些词语被滥用最严重并循环操作,直到最后不再冒出新的slop。antislop的作者也提出了FTPO来尝试抑制模型滥用slop的问题,其核心思想是在slop要出现的位置上把slop token的logit压到几个通顺替代词之下,并限制替代token logit与slop token logit的差异幅度,从而抑制模型slop的生成。最终发现,在写作质量轻微下降的基础上,模型较好地抑制了slop,并且总的 slop 真的变少了,而非换了一批新slop。
(值得一提的是,antislop的作者还有一个eq-bench,也是有评估模型的语言表达能力)
最近,复旦清华也有团队 [3] 专门聚焦于”不是…而是“这个句型,发现5个前沿模型使用不是而是的密度是人类的2.5-9.2倍,并且这些表达主要是”不恰当“的多余表达,即模型使用”不是…而是“并没有推进讨论,测试也没有提供使用”不是而是“的语境。作者尝试进行归因分析,发现这一结果的原因一方面是reward model对这个句式本身就有偏好,而这个偏好可能又来源于输出的长度偏好;另一方面是模型在SFT和DPO后输出的“不是而是”句式要显著高于base model。
除此之外,也有许多工作在讨论LLM生成的用词、句式存在固定的模板特征,缺乏多样性的表达,但在我看来这一结果如同AI生成的UI风格趋同一般并不奇怪,属于模型本身架构决定的特征。因此在这里不详细介绍。
信息密度的不一致
除了用词、句式偏好差异外,也有许多人反馈模型输出的内容防御性很强。一个有趣的现象是,模型整体输出的内容会显得“空与泛”,但是在具体内容读起来却十分疲惫。对于前者,我们可以用防御性写作来理解,即模型在表达一个观点时,会加入不必要的限定与纠正,然而这些限定往往并没有提供实质信息。最近电子科大与上海交大团队 [4] 测试了GPT系列改写学术段落时的这一倾向,发现单纯润色并不会触发防御,但一旦要求模型应对审稿人的潜在质疑,高版本GPT就会密集塞入缺乏依据的免责限定,甚至在约40%的结果分析段落中直接撤回作者原有的结论。人工核查显示,这些额外限定中有60%都属于字面挑不出错、却毫无增量信息的冗余表达;偏偏AI审稿人更偏爱这种写法,删去冗余限定反而会导致AI打分下跌,而人类读者只会觉得行文割裂、作者底气不足。
而对于后者,NYU与UT Austin的一项研究 [5] 从“均匀信息密度”的观点解释了这个现象:人类说话时会把信息均匀分布在句子里,避免读者在某处一下子接收太多,为此人们常会主动加上一些可有可无的虚词(如英文从句中的引导词 that)作为缓冲;而AI的目标往往是最大化信息密度,如果只追求用最少的token表达同样的意思,那么同一意思有长短两种说法时,模型就会一律选短的。作者将这一结果归因于脱离人类反馈的后训练(如RLVR)与长度惩罚,同时也发现base model相较于经过后训练的reasoning model,在文本可读性上要更强。另一项基于人类眼动数据预测阅读耗时的研究 [6] 也印证了这种代价:对比人类新闻原稿与模型的等价改写后发现,模型虽然压缩了总词数,却换用了更长、更低频的词汇,导致平均每个词的阅读耗时反而上升,且篇幅压缩得越狠,单个词的阅读成本就越高。
此外,24年就有一篇CHI的工作 [7] 通过专业作家的修改实验,说明了AI输出相较于人类会存在过度的华丽修辞和不必要的冗长叙述等问题。这篇工作主要建立了很好的语言特征分类学,但评测的模型和今天已经有些距离,在此仅做简要介绍。
Common Ground的差异
除了信息密度的差异外,AI“不说人话”还源于交互过程中共同认知基础(Common Ground)的缺失,主要体现在模型既爱用人类较难消化的非常规词汇句式,又常直接输出当前用户并不理解的私有信息。对于第一点,前文NYU与UT Austin的研究 [5] 指出,前沿模型还会频繁造出偏离人类日常语感的表达,例如临时把名词当动词用(如 calendar it、footnote it)、让无生命主语搭配动作动词(如 is_file() swallows that),以及堆叠多重名词和生僻词组。人类语言在演化中会自然淘汰阻碍理解的说法,但大模型拥有无损的长上下文注意力和庞大语料先验,加上后训练逐渐转向代码、数学等机器验证任务,便演化出了一套内部表征高效、人类读起来却格外拧巴的“AI方言”(开头提到的AI短剧台词也有这种影子)。
对于第二点,这种视角错位在多步执行的Agent场景中尤为突出。最近华东师大与上海AI Lab等团队 [8] 评估了8个主流模型在多轮Agent任务中的“回复可用性”。由于Agent在后台调工具、查资料和记笔记时会形成一套用户看不见的私有语境,站在用户可见视角测试后发现,高达54%的默认回复是不可用的,且后台调用工具的轮数越多,最终回复就越难懂。问题主要集中在两类信息断层:一是直接引用用户从未见过的后台材料(如内部检索编号 R07),二是把自己在私有笔记里随手编造的实验代号或配置名(如 crn_hierbm25_L)不加解释地直接抛给用户。更有意思的是,仅在system prompt里提醒模型“用户没看过你的工具调用和笔记”几乎毫无作用,必须显式规定解释未见概念、进行多次采样或用辅助模型二次改写,才能有效对齐双方的common ground。
Language,Taste与Human-centered tasks
实际上,早在ChatGPT刚问世时就有了AIGC detection的相关工作,围绕AI写作的讨论也持续至今,其中一个被广泛认同的观点是:“只要内容有价值,是否由AI生成其实并不重要。”然而,随着模型在coding和math能力上不断走高,人们却发现它的语言表达越来越晦涩难懂。今天我们希望模型“说人话”,并非指责AI代劳人类的写作,真正想说的是模型在替人写作和表达这件事上反而越做越差了。我们期待语言回归作为交流与理解的工具。尤其是最近DeepSeek关于harness super agent的讨论中也提到,在多session的场景下,人的注意力正越来越成为与agent协作的瓶颈;此时,好的语言表达能力本身就是对人类注意力资源的保护。然而,怎么scaling模型“说人话”的能力依旧是一个挑战,可以看到,如果给模型施加长度惩罚,那么模型就会过度压缩;而如果不给模型施加长度惩罚,那么模型则会多余地使用“不是…而是”这样的固定slop句式。
从这个角度看,所谓taste,在我看来其实是在有限资源约束下做出决策与取舍的质量,其核心是对value和cost有准确的估计。写作恰恰是一个不断权衡value和cost,体现agent taste的过程:一方面,作者需要判断在论文的问题阐述、方法介绍与结果汇报中,哪些high-value的内容应该被强调,哪些low-value的细节应该被省略;另一方面,作者也需要估计读者的阅读cost,换位思考读者此时的知识背景、认知负荷和注意力,并据此组织表达。然而,模型往往缺少这样的tacit knowledge和取舍的魄力。因此在我看来,语言表达和写作也是模型展现taste的重要场景。并且,写作的taste也是高度个性化的,每个人对value,cost的感受都会不一样,在模型不确定value和cost的时候,怎么让模型高效从人类身上校准,会是一个非常重要的事情。
至于开头提到的generation diversity问题,我个人认为这一方面与base model本身的生成能力有关,另一方面也离不开人的参与(human engagement)。以语言写作这类human-centered tasks为例,很难苛求模型在不交互的情况下,单轮直接输出既多样又契合长尾场景rubrics的内容;我们更应该关注单轮生成之后模型与人类协作的过程,即“人类如何高效地将自我的context传达给模型”。例如,模型第一轮写出的剧本当然可以是“贵是贵了点,但吃了不烧心”这类模板句;但如果在收到一轮人类的personalized feedback后,模型能把其中个性化的意图与语境高效地注入修改之中,最终呈现出的diversity自然会好很多。
References
[1] Measuring AI “Slop” in Text. COLM 2026.
[2] Antislop: A Comprehensive Framework for Identifying and Eliminating Repetitive Patterns in Language Models. ICLR 2026.
[3] Not X, but When: Diagnosing a Mandarin LLM Writing Tic through Contextual Appropriateness. arXiv 2026.
[4] Defensive Writing in GPT Models. arXiv 2026.
[5] Why is AI-generated language so hard to understand? arXiv 2026.
[6] The Cognitive Cost of LLM Writing: A Reading-Time Comparison with Human Text. arXiv 2026.
[7] Can AI writing be salvaged? Mitigating Idiosyncrasies and Improving Human-AI Alignment in the Writing Process through Edits. CHI 2025.
[8] Measuring and Reducing Unusable Replies of LLM Agents. arXiv 2026.